Задача: Отформатировать контент
Отформатировать контент
Исправить плохое оформление страниц после некачественного обновления сайта.
Отформатировать контент
Сейчас многие страницы сайта оформлены некачественно — это результат неудачного обновления сайта.
Нужно пройти по проблемным страницам и привести контент к аккуратному, единообразному виду.
Что сделать
- выявить страницы с нарушенным или неаккуратным форматированием;
- исправить структуру заголовков, списков, абзацев и других блоков;
- убрать визуальные артефакты и следы некорректной миграции/обновления;
- привести оформление к единому стилю по сайту;
- проверить итоговое отображение страниц после правок.
Результат
Контент на страницах должен выглядеть аккуратно, последовательно и без явных следов некачественного обновления сайта.
Так же надо поправить картинки, там как раньше были пути типа /assets/images/resized/2015/1563/513a9fb28b.jpg , сейчас эти картинки не доступны, хотя физически есть.
Ворклоги
Зафиксирован прогресс по автоматическому восстановлению форматирования старого контента после миграции из draft-editor.
Написан резолвер, который берет старые варианты контента (contentText и content) и через ИИ-агента пересобирает публикацию в Markdown с сохранением исходных слов, смысла и стилистики.
import { Resource } from '@prisma/client'
import { PrismaContext } from 'server/context/interfaces'
import {
  LLMChatMessageRole,
  LlmModel,
  LlmProvider,
} from 'server/llm/client/interfaces'
import { llmChatCompletionResolver } from 'server/schema/types/LLM/resolvers/chatCompletion'

type ProcessConceptsArgs = {
  ctx: PrismaContext
  resource: Resource
}

export async function processOldContent({
  ctx,
  resource,
}: ProcessConceptsArgs): Promise<string | null | undefined> {
  const systemPrompt = `# Ты рерайтер.

Тебе будут даны разные варианты текста одной и той же публикации. Это может быть и чистый текст, и технический со всякими техническими тегами и т.п. Твоя задача пересобрать полностью статью, с сохранением слов, смысла и стилистики, но оформить все в формате маркдаун.

Так же могут быть приведены листинги кода, их надо вставить в блок кода с указанием языка. Например

\`\`\`js
const foo = 0
\`\`\`

Список всех поддерживаемых языков:
'': 'Plain Text',
text: 'Plain Text',
js: 'JavaScript',
ts: 'TypeScript',
tsx: 'TypeScript (React)',
jsx: 'JavaScript (React)',
css: 'CSS',
html: 'HTML',
json: 'JSON',
bash: 'Bash',
shell: 'Shell',
sql: 'SQL',
gql: 'GraphQL',
python: 'Python',
markdown: 'Markdown',
django: 'Jinja/Django',
env: 'Environment',
yaml: 'YAML',

Если никакой не подходит, то не указывай явно используемый язык.


## !!! Очень важно !!!

Важно сохранить смысл, слова и стилистику. Твоя задача отформатировать статью, а не переписать ее своими словами. Нельзя ничего додумывать, придумаывать и т.п. Если где-то есть недосказанность, эта недосказанность так и должна остаться - твоя задача только отформатировать статью.

Вернуть надо только отформатированную статью в формате маркдаун, без какого-либо технического сопроводительного кода, текста, твоих комментариев и т.п. Только сама статья.


## Форматирование конечной публикации

Корректный Markdown с поддержкой html (но предпочтительней именно маркдаун форматирование)

Важно учитывать, что много где пропущены пробелы в тексте. Очень важно распознавать такое и корректно вставлять пробелы.

Картинки вставляются как картинки с предпросмотром. Ссылки как ссылки.

Если встречаются ссылки, ссылающиеся на домен community.modx-cms.ru, то вставляй просто текстом, а не ссылкой.
На другие домены вставляй ссылки как есть.

Если есть картинки с внешних файлообменников типа joxi и т.п., не надо их вставлять, они не актуальны. Локальные картинки обязательно вставляй, где они указаны.
`

  const {
    content,
    contentText,

    /**
     * contentV2 не берем, потому что он формировался из content и contentText
     */
    // contentV2
  } = resource

  const peaces = [contentText, content]
    .map((n) =>
      n === null ? null : typeof n === 'string' ? n.trim() : JSON.stringify(n),
    )
    .filter((n) => !!n)

  if (!peaces.length) {
    return ''
  }

  const userPrompt = `## Вот тебе исходные данные статьи. Перепиши это в конечную статью в формате маркдаут, с сохранением слов, смысла и стилистики, и верни мне только ее, без всякого дополнительного технического текста и твоих комметариев

---

${peaces.join(`

---

`)}

`

  const chatResponse = await llmChatCompletionResolver(
    null,
    {
      input: {
        provider: LlmProvider.OpenRouter,
        messages: [
          {
            role: LLMChatMessageRole.system,
            content: systemPrompt,
          },
          {
            role: LLMChatMessageRole.user,
            content: userPrompt,
          },
        ],
        // eslint-disable-next-line @typescript-eslint/no-explicit-any
        model: LlmModel.GEMINI_3_5_FLASH_LITE as any,
      },
    },
    ctx,
  )

  const responseContent = chatResponse.choices?.[0]?.message?.content

  return responseContent
}
Статистика выполнения:
- 100 публикаций — около 5 минут, бюджет ~$0.30.
- 1296 ресурсов — около 43 минут, бюджет $2.53.
В целом обработка отработала нормально: текст стал заметно более удобочитаемым. До этого после миграции из draft-editor значительная часть публикаций превратилась фактически в сплошной текст без исходного форматирования.
При этом автоматическая обработка не дает полностью чистый результат и оставляет отдельные артефакты. Например, встречается такой результат:
В create- процессоре она есть, а в update- процессоре ее нет. Уточню, что это ключ массива данных, передаваемых в массив
s
c
r
i
p
t
P
r
o
p
e
r
t
i
e
s
,
доступныйвнавешиваемыхплагинах
.
Приэтомониещеисоветуютэтотключнеиспользовать
,
ииспользуйтетипаключ
scriptProperties,доступныйвнавешиваемыхплагинах.Приэтомониещеисоветуютэтотключнеиспользовать,ииспользуйтетипаключthis->objectType.
Исходный HTML этого предложения:
<p>В create- процессоре она есть, а в update- процессоре ее нет. Уточню, что это ключ массива данных, передаваемых в массив <span class="katex"><span class="katex-mathml"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>s</mi><mi>c</mi><mi>r</mi><mi>i</mi><mi>p</mi><mi>t</mi><mi>P</mi><mi>r</mi><mi>o</mi><mi>p</mi><mi>e</mi><mi>r</mi><mi>t</mi><mi>i</mi><mi>e</mi><mi>s</mi><mo separator="true">,</mo><mtext>доступныйвнавешиваемыхплагинах</mtext><mi mathvariant="normal">.</mi><mtext>Приэтомониещеисоветуютэтотключнеиспользовать</mtext><mo separator="true">,</mo><mtext>ииспользуйтетипаключ</mtext></mrow><annotation encoding="application/x-tex">scriptProperties, доступный в навешиваемых плагинах. При этом они еще и советуют этот ключ не использовать, и используйте типа ключ </annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.8778em;vertical-align:-0.1944em"></span><span class="mord mathnormal" style="margin-right:0.0278em">scr</span><span class="mord mathnormal">i</span><span class="mord mathnormal" style="margin-right:0.1389em">ptP</span><span class="mord mathnormal" style="margin-right:0.0278em">r</span><span class="mord mathnormal">o</span><span class="mord mathnormal">p</span><span class="mord mathnormal" style="margin-right:0.0278em">er</span><span class="mord mathnormal">t</span><span class="mord mathnormal">i</span><span class="mord mathnormal">es</span><span class="mpunct">,</span><span class="mspace" style="margin-right:0.1667em"></span><span class="mord cyrillic_fallback">доступныйвнавешиваемыхплагинах</span><span class="mord">.</span><span class="mord cyrillic_fallback">Приэтомониещеисоветуютэтотключнеиспользовать</span><span class="mpunct">,</span><span class="mspace" style="margin-right:0.1667em"></span><span class="mord cyrillic_fallback">ииспользуйтетипаключ</span></span></span></span>this->objectType.</p>
Здесь проблема уже заложена в старом HTML: обычный текст оказался завернут в KaTeX/MathML, из-за чего модель пытается интерпретировать сильно искаженную структуру и местами дублирует/разбивает текст.
Вывод: автоматическая обработка существенно улучшает базовое состояние контента и подходит как массовый первый проход, но финальная вычитка и небольшие ручные правки все равно нужны.
Объем — около 1500 топиков за 13 лет. С учетом того, что большая часть после обработки визуально уже вполне читабельна и ручного внимания требуют в основном отдельные артефакты и местами сложная верстка, объем финальной ручной работы выглядит приемлемым.
Полный AI-проход по ресурсному корпусу и экономика обработки
После первого прохода по топикам обработка была расширена на весь ресурсный корпус: топики, комментарии, блоги и прочие сущности, унаследованные от общей модели Resource (исторически — от MODX site_content).
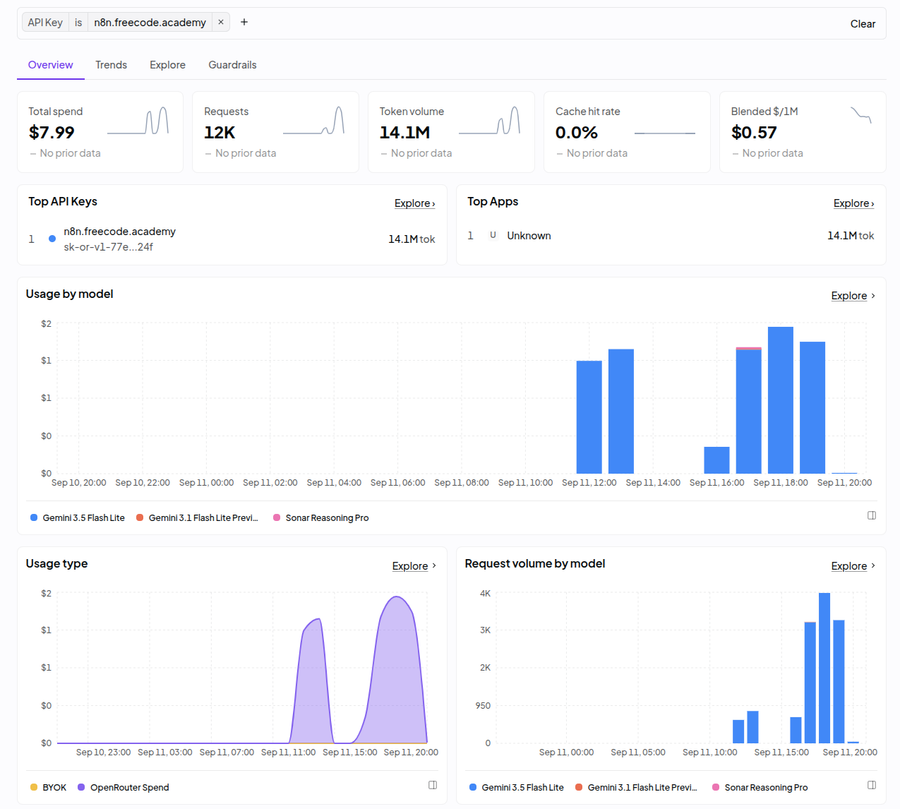
По данным OpenRouter итоговый пакет составил примерно 12 000 AI-запросов, 14,1 млн токенов и около $7.99 расходов. Почти вся массовая обработка выполнялась на Gemini 3.5 Flash Lite.
Это практически совпадает с масштабом текущего архива: только Topic + Comment дают 11 890 сущностей (1 349 топиков и 10 541 комментарий), а с блогами и прочими типами общий объём естественно выходит примерно к 12 тысячам ресурсов.
Практический вывод оказался важнее самой миграции Markdown: полный управляемый AI-проход по многолетнему публичному архиву стоит единицы долларов. Изначально ожидался порядок 8.
Это меняет экономику контента. Теперь можно не ограничиваться одноразовой миграцией, а делать специализированные повторные проходы по всему корпусу: нормализацию, классификацию, выделение сущностей и утверждений, построение связей, поиск изменений позиций, тематические ретроспективы, provenance и подготовку новых публикаций. Стоимость полного машинного прочтения корпуса становится сопоставима с обычной технической операцией, а не с редакционной работой.
На уровне модели распространения это даёт ещё один вывод: человек может передать AI ядро мысли, AI — догуглить и собрать контекст, затем опубликовать управляемый набор материалов на одном или нескольких сайтах. Дальше эти материалы становятся доступными другим AI-агентам и могут входить в их ответы через GEO/AI-search. То есть дешёвая массовая генерация здесь используется не ради спама, а как управляемая публикационная инфраструктура для распространения проверяемых идей и экспертизы.