Ворклоги
Сайт опубликован https://newpg.ru/ Только еще не все страницы восстановлены. Завтра восстановлю.
12.10.2026. По запросу владельца создан проект newpg.ru в fi1osof.ru и поставлена задача возродить сайт веб-студии. В проект внесены исторические сведения о «Новой парадигме», ранних технических статьях, утрате прежнего сайта и профессиональной цепочке MODX.club → Prisma CMS → Freecode Academy с современными направлениями fi1osof.ru / haih.site. Подготовлена постановка с аудитом исторических URL, разработкой, тестированием и критерием фактического запуска. Разработка и публикация сайта пока не выполнялись.
Сайт запущен
Зафиксирую задним числом запуск первых трех сайтов:
Исходный ворклог от 07.10.2026.
Настроена базовая система собственной аналитики для уже запущенных сайтов: сбор клиентских событий через JavaScript и сопоставление их с серверными логами. Это позволяет отдельно видеть активность реальных пользователей, поисковых роботов, мониторинга, сканеров и прочего технического трафика. Заложена основа для дальнейших антифрод-фильтров и замеров нагрузки/стоимости до и после фильтрации.
Опубликованы две статьи по проекту:
- https://как-продвинуть-сайт.рф/blog/pochemu-ya-zapuskayu-etot-eksperiment — почему запущен эксперимент с минимум 50 сайтами: прежняя модель органического трафика перестаёт работать, поэтому нужен практический поиск новых способов самостоятельного продвижения.
- https://как-продвинуть-сайт.рф/blog/svoya-analitika-i-antifrod — о собственной аналитике и антифроде: как отличать живых пользователей от ботов и технического трафика, сопоставлять клиентские события с серверными логами и измерять реальную стоимость трафика.
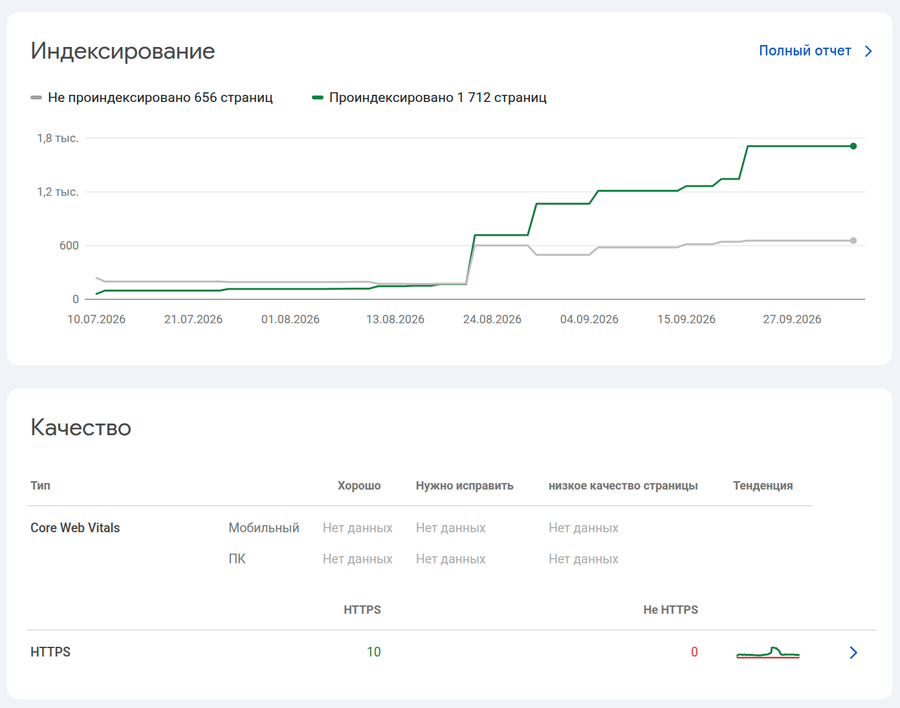
Проиндексировано уже 1700+ страниц
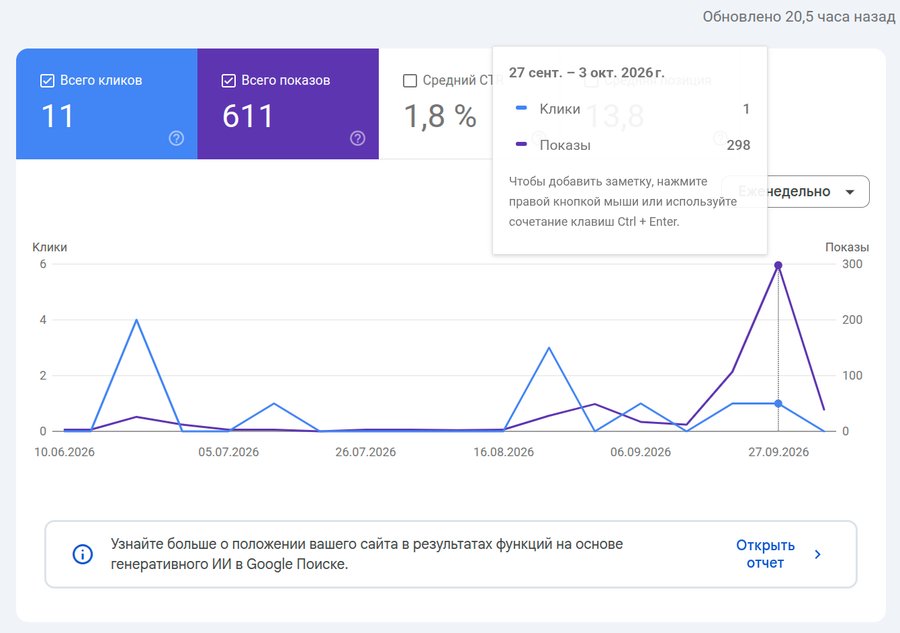
Показы растут, клики нет.
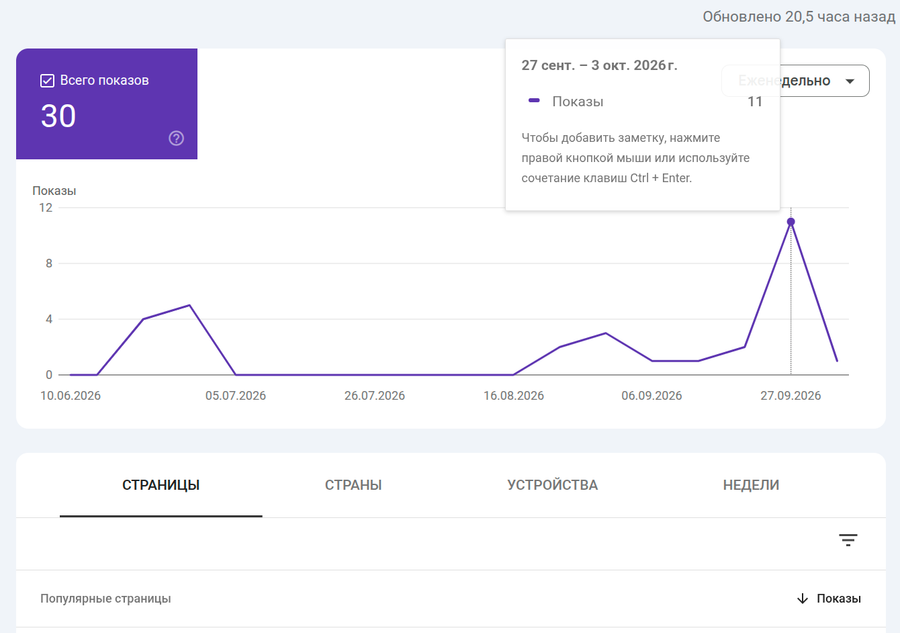
Генеративная выдача слабо.
Проиндексированных уже 7500+ страниц
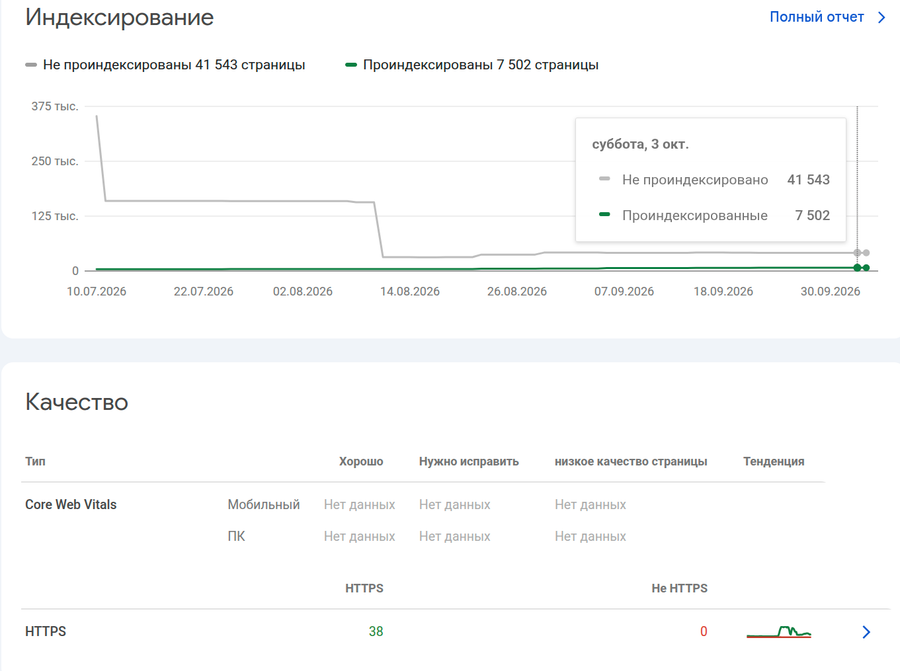
Но за последний месяц все еще ни одной страницы новый в выдаче.
а за год - всего две.
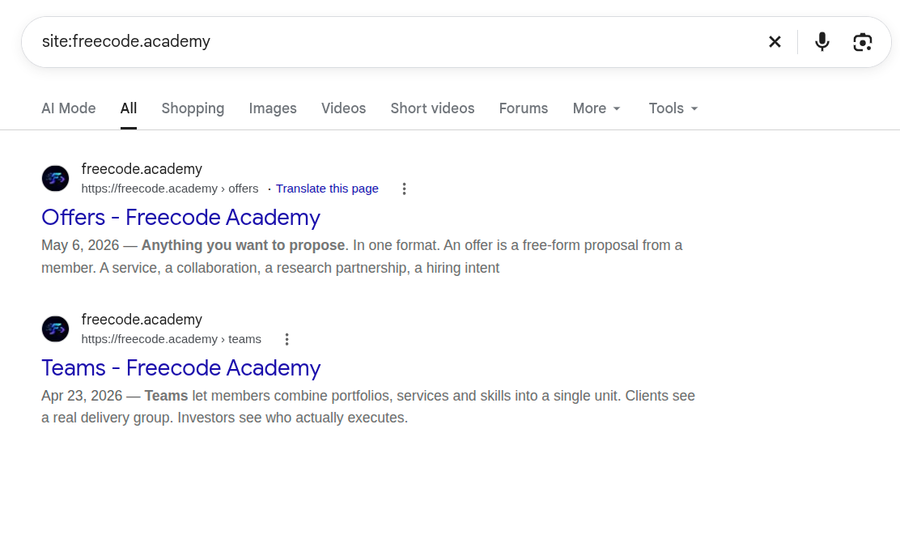
Две страницы за год, Карл.
Клики/показы активно падают.
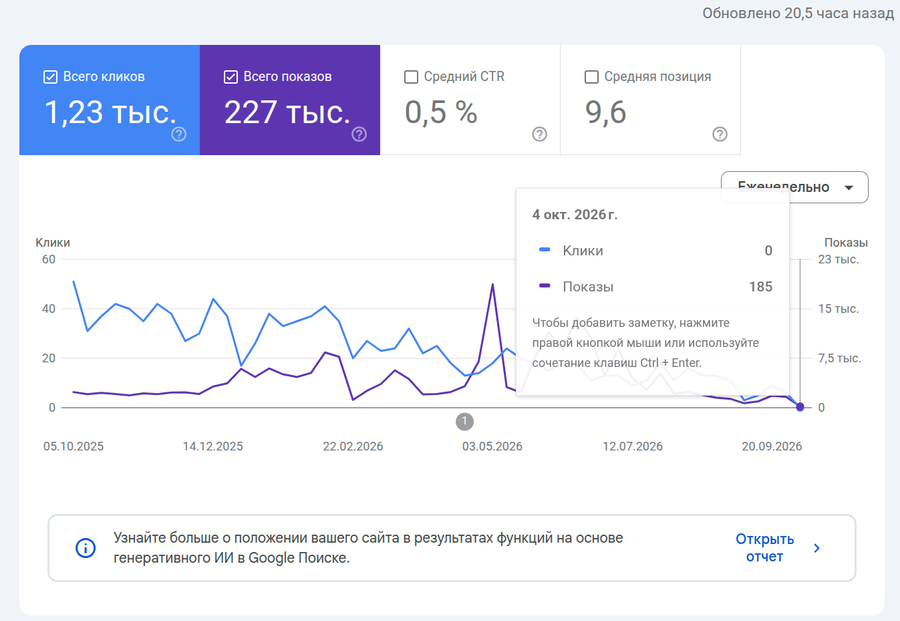
Генеративная выдача - не понятно.
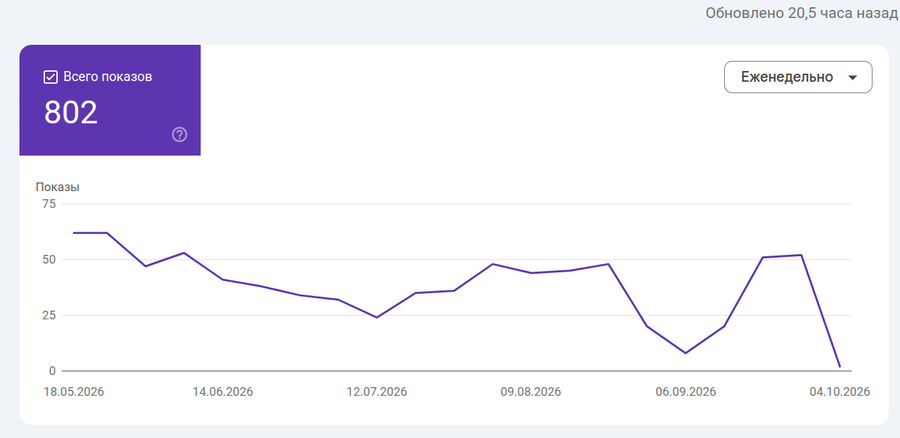
Кстати, обратите внимание на аномальный сплеск показов в мае. Там была группировка по неделям, вот делаю по дням. Это в первую очередь отдельный всплеск выдачи за отдельный день - почти 7 000.
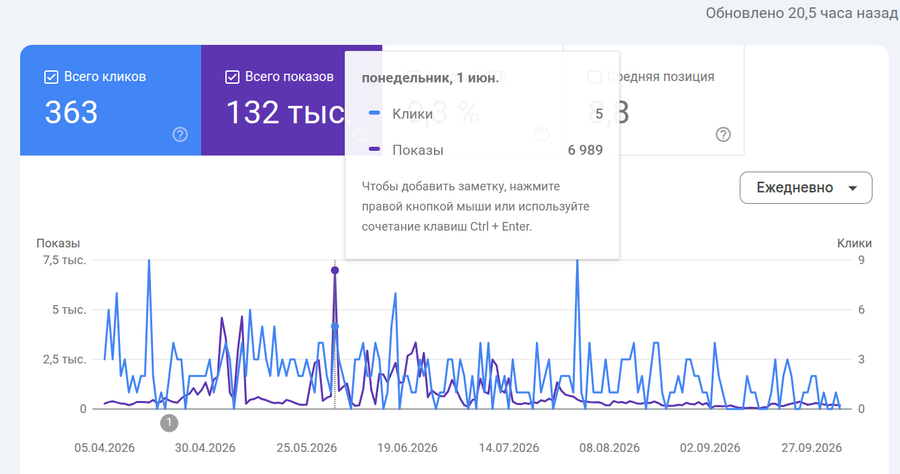
И нет, это никак не кореллируется с кликами. Вот давайте посмотрим только на показы:
Неделей ранее 220 показов, неделей позднее 157 показов, а тут почти 7000. То есть разница более чем в 15 раз. По кликам такой аномалии нет.
Кто попробует объяснить это кроме как автоматизированной актиностью? То есть кол-во показов и кликов - это уже давным давно не "Сколько нас людей увидело и посетило".
Сайт как-продвинуть-сайт.рф вынесен в отдельный проект: /projects/cmuymjnak0106nw0p28llboa4.
Сайт как-продвинуть-сайт.рф был фактически сделан и запущен в рамках общего ворклога: /worklogs/cmuy98sq801pcnw0qakldqkfd.
За сегодня сделаны и запущены 3 сайта:
Работы выполнены агентом под руководством пользователя: создание сайтов, наполнение контентом, настройка инфраструктуры, настройка двух отдельных новых серверов, публикация и запуск сайтов. Таким образом, уже отработана значимая часть полного цикла — от постановки и сборки сайта до серверной настройки и вывода в продакшн.
После нескольких часов экспериментов с новой системой планирования удалось существенно лучше понять как ограничения текущей реализации, так и ограничения самого подхода к разработке через AI-агента. Часть решений агент реализовал удачно, однако в целом система пока не соответствует моим требованиям, и дальнейшее локальное исправление отдельных проблем перестало выглядеть эффективным.
Особенно показательной оказалась попытка регресса и упрощения системы. Агенту было явно указано, какие части реализации следует удалить или упростить, но вместе с ними он затронул и другие элементы, которые должны были сохраниться. Это показало важное ограничение: агент способен работать с отдельными фрагментами и локальными зависимостями, но хуже удерживает границу между целевым упрощением и разрушением связанного поведения. Когда система состоит из нескольких взаимосвязанных подсистем, локально разумные изменения могут нарушать связи, которые не были явно описаны в текущем контексте.
Из этого следует более общий вывод о разработке с AI. Если агент начинает многократно исправлять последствия собственных предыдущих изменений, продолжение такого цикла быстро приводит к накоплению кода, обходных решений и неявных зависимостей. В какой-то момент проблема уже заключается не в конкретном баге, а в утрате простой и проверяемой модели системы. Попытка поручить агенту ещё и глубокий рефакторинг в таком состоянии несёт риск дальнейшего роста сложности: он может корректно оптимизировать отдельные участки, не понимая, какие свойства всей системы должны остаться неизменными.
Поэтому требуется переосмыслить этапы разработки. Вероятно, основной объект контроля должен смещаться с внутренней реализации на внешнее поведение системы: требования, инварианты, сценарии, тесты и связи между подсистемами. Если реализация перестаёт удовлетворять этим требованиям и агент не может быстро вернуть её в корректное состояние, может быть выгоднее не продолжать бесконечный repair-loop, а зафиксировать нужное поведение, упростить модель и пересобрать реализацию заново. Иными словами, код в таком процессе стоит рассматривать скорее как заменяемый артефакт, а не как актив, который необходимо любой ценой сохранять и постепенно чинить.
Эксперимент оказался полезен именно тем, что выявил предел локального AI-рефакторинга: агенту трудно самостоятельно определить, где заканчивается допустимое упрощение и начинается разрушение системных связей. Следующий этап работы стоит строить вокруг более явной спецификации поведения и границ подсистем, а не вокруг дальнейшего исправления уже накопившейся реализации.
Вот что чатгпт говорит:
Да, обрыв запроса в браузере может приводить к отмене генерации у провайдера — если ваш бэкенд связывает эти два соединения и передаёт отмену дальше. Но отсутствие поддержки потоковых ответов в современном Chrome — маловероятная причина: fetch() поддерживает чтение ответа через ReadableStream. MDN
Здесь нужно разделить два участка: браузер → ваш сервер и ваш сервер → провайдер. Если браузер оборвал запрос, сервер может отменить запрос провайдеру через AbortController. Тогда обработчик ошибок действительно может принять эту отмену за «провайдер прервал генерацию». Сам текст ошибки ещё не доказывает, кто первым оборвал соединение. Отмена через AbortSignal может завершать HTTP-запрос с AbortError. Node.js v26.10.0 Documentation
Проверить наличие API можно прямо в консоли браузера:
const supportsResponseStreaming =
  typeof fetch === 'function' &&
  typeof ReadableStream === 'function' &&
  typeof Response === 'function' &&
  'body' in Response.prototype &&
  typeof ReadableStream.prototype.getReader === 'function';

console.log({ supportsResponseStreaming });
Это проверяет поддержку чтения потокового ответа. Отдельной браузерной функции «поддерживается HTTP Streamable» нет; если речь об обычном запросе с JSON и потоковом ответе агента, нужна именно эта возможность. Потоковая отправка тела запроса — другая возможность, со своими ограничениями. MDN
Но true не гарантирует, что поток нормально проходит по всей цепочке. Для этого нужен тестовый endpoint на вашем сервере, который отправляет, например, пять сообщений с интервалом в секунду, и проверка в браузере:
async function testStream(url) {
  const started = performance.now();
  const response = await fetch(url, { cache: 'no-store' });

  if (!response.ok) throw new Error(`HTTP ${response.status}`);
  if (!response.body) throw new Error('Нет тела ответа');

  const reader = response.body.getReader();

  try {
    while (true) {
      const { done, value } = await reader.read();
      if (done) break;

      console.log({
        elapsedMs: Math.round(performance.now() - started),
        bytes: value.byteLength,
      });
    }
    console.log('Поток завершён');
  } catch (error) {
    console.error('Ошибка чтения потока:', error);
  } finally {
    reader.releaseLock();
  }
}

testStream('/api/stream-test');
Адрес здесь условный — endpoint нужно реализовать. Чтение через getReader() позволяет наблюдать поступление частей ответа. Границы сетевых частей не обязаны совпадать с границами сообщений сервера. MDN
Интерпретация:
- Части приходят постепенно — поток проходит.
- Всё приходит одним куском в конце — где-то есть буферизация.
- Чтение падает с ошибкой — соединение или обработка потока нарушены; причина требует сопоставления с серверным логом.
Для вашего случая решающая проверка — порядок событий в логах одного запроса: отключение клиента, вызов отмены запроса провайдеру, ошибка чтения ответа провайдера. Если сначала отключается клиент, а затем ваш код отменяет генерацию, гипотеза подтверждается. Если первым повреждается поток от провайдера — причина на другом участке.
Разница «ноутбук / мобильный» сама по себе пока указывает лишь на различие условий: сеть, VPN, расширения, версия фронтенда или его логика отмены запроса. Выбрать конкретную причину по этому признаку нельзя.
Минимальная событийная модель агента и LLM
Реализован базовый слой реакции агента, пригодный как строительный блок будущего runtime:
- класс
Agentи endpointPOST /api/agent; - базовая цепочка
message.received → Agent.react → message.publish; - связь действия с исходным событием через
stimulusIdи собственныйactionId; - JSON/NDJSON и общий механизм отмены;
Agent.reactтеперь вызывает реальныйrunChat/LLM вместо мока;- повторно прошли 2/2 теста агента на фрагменты/идентичность action, отмену и ошибку провайдера.
Текущая реализация обрабатывает один тип входящего события и канал chat; модель получает только текущее сообщение. Пока нет памяти разговора, накопления нескольких событий, дедупликации, общей системы принятия решений и сценарной машины переходов.
Фундамент runtime: потоковое выполнение и отмена
Для будущего собственного диалогового runtime уже реализован низкоуровневый механизм исполнения:
- общий
ExecutionContextс идентификатором запуска, abort signal и доставкой событий; - потоковый NDJSON-контракт
POST /api/chat; - корректные состояния started/delta/done/error/cancelled;
- явная отмена выполнения и отмена по disconnect/timeout/shutdown;
- независимость параллельных запусков;
- ограничения входа и размера ответа.
HTTP-слой повторно проверен 8/8 тестами.
Это не означает готовность сценарного движка: декларативная модель сценария, узлы/ветвления, версия сценария, персистентное состояние диалога, идемпотентность сообщений и атомарные переходы ещё не реализованы.
Интеграция существующего сайта с новым центром агентов
Реализована совместимость со старым чат-интерфейсом соседнего проекта agent:
- через
CHAT_AGENT_URLчат можно направлять в новый агент, а без настройки сохраняется прежний путь к n8n; - адаптер преобразует сообщения старого клиента в события нового агента;
- ответы
started/delta/doneпреобразуются обратно в старый форматbegin/item/end; - учтены разрезанные UTF-8/JSON-фрагменты, ошибки, незавершённые потоки, медленный клиент и отключение потребителя;
- связанные изменения:
be06299,4fe6d85,c2a8ded.
Повторно прошли 3/3 локальных теста адаптера.
Ограничения текущего состояния: это проверочная интеграция через старый интерфейс, а не собственный новый встраиваемый виджет. sessionId, пользовательский токен и адрес страницы пока не передаются новому агенту; памяти/контекста посетителя нет. Старый сайт на порту 3000 во время последней проверки не был запущен, поэтому живой end-to-end через него повторно не проверялся.
HTTP-чат и минимальная событийная реакция агента
Реализованы серверные контракты, на которых может строиться центральный сервис диалогов:
POST /api/chatподдерживает обычный JSON и потоковый NDJSON;- единый
ExecutionContextнесёт execution id, режим ответа, abort signal и отправку событий; - поддержаны старт, последовательные delta, успешное завершение, ошибка и отмена;
- есть явная отмена через DELETE, отмена при disconnect/timeout/shutdown и независимость параллельных запусков;
- реализованы класс
AgentиPOST /api/agentс цепочкойmessage.received → Agent.react → message.publish; - действия связаны со stimulus через
stimulusId, фрагменты одного ответа имеют общийactionId; - мок реакции уже заменён реальным вызовом существующего
runChat/LLM.
Повторные проверки из аудита: HTTP-чат 8/8 тестов, реакции агента 2/2 теста.
Это фундамент диалоговой части, но пока без постоянной памяти разговора, дедупликации событий и общей модели сайтов/посетителей/диалогов.
Серверный фундамент и LLM/API
По фактическому состоянию проекта реализован базовый серверный слой центра агентов:
- добавлены GraphQL-операции
llmChatCompletion,llmCompletion,llmImageGeneration,llmSpeechGeneration; - общий LLM-клиент поддерживает Local и OpenRouter, ключи остаются на сервере;
- добавлен общий контекст выполнения и WebSocket-транспорт GraphQL;
- GraphQL LLM-операции сейчас защищены авторизацией активного пользователя;
- реализованы PostgreSQL/Prisma и серверный слой аккаунтов (
User,Token, регистрация, вход, профиль, сессии, JWT + проверка сохранённой сессии, bcrypt, отзыв сессий); - добавлен bootstrap БД и исправлен production-запуск/сборка.
Связанные коммиты, зафиксированные в аудите: d3bea97, ea2c78e, b8ce41b, bc95738.
Повторно подтверждено локально: TypeScript checks успешны, соответствие БД Prisma-контракту успешно, подключение к agents-center с хоста и из контейнера успешно, новый сервер на порту 3001 отвечает HTTP 200, через прокси на 8080 также HTTP 200.
Важно: постоянное хранение разговоров и полноценные сущности сайтов/агентов/диалогов/сообщений как продуктовый слой ещё не завершены.
Прогресс на 30.09.2026
Baseline производительности и качества старого сайта снят и сохранён.
Для главной страницы зафиксированы лабораторные показатели:
- Mobile Performance: 54 (медиана 3 запусков)
- Desktop Performance: 67
- Accessibility: 58 / 58
- Best Practices: 73 / 77
- SEO: 100 / 100
- Mobile LCP: 26,17 с (медиана)
- Desktop LCP: 4,56 с
- Объём ресурсов: около 4,83–4,87 MB
Также сохранены четыре Lighthouse-отчёта. Это лабораторные измерения, не полевые Core Web Vitals.
На новом HAIH уже устранён старый prerender, блокировавший production build, и реализован request-time SSR fallback. Однако оптимизация изображений, JS/CSS, кеширования, accessibility и production-пути Traefik → Varnish → Node ещё не выполнена и повторные Lighthouse-замеры новой версии пока не зафиксированы.
Следующий контрольный этап — измерить новую главную и ключевые коммерческие страницы в одинаковых условиях и последовательно довести Performance/Accessibility/Best Practices до целевых значений без ухудшения SEO.
Прогресс на 30.09.2026
Текущий калькулятор исследован и проблема подтверждена воспроизводимым сценарием.
В baseline калькулятор пройден до финального запроса контактов: пользователь отвечает на восемь вопросов, но цена или иной полезный результат до ввода телефона и e-mail не показывается. То есть фактически подтверждена механика, из-за которой пользователь сначала тратит время, а обещанный результат получает только в обмен на контакт.
Сохранены desktop/mobile-материалы исходного интерфейса и пользовательский сценарий, поэтому есть база для сравнения новой версии.
Переделка пока не реализована. Следующий этап — определить минимальный набор параметров, реально влияющих на стоимость, сократить сценарий и показывать ориентировочный результат до обязательного запроса контакта, а затем измерять не только lead submitted, но и прохождение до результата и дальнейшую конверсию.