Nhiệm vụ: Định dạng lại nội dung
Định dạng lại nội dung
Khắc phục tình trạng trình bày trang kém sau khi cập nhật trang web kém chất lượng.
Định dạng lại nội dung
Hiện tại, nhiều trang trên trang web được trình bày kém — đây là kết quả của một đợt cập nhật trang web không thành công.
Cần rà soát các trang có vấn đề và đưa nội dung về trạng thái gọn gàng, đồng nhất.
Cần làm gì
- xác định các trang bị lỗi hoặc định dạng cẩu thả;
- sửa cấu trúc tiêu đề, danh sách, đoạn văn và các khối khác;
- loại bỏ các lỗi trực quan và dấu vết của việc chuyển đổi/cập nhật không chính xác;
- đưa thiết kế trình bày về một phong cách thống nhất trên toàn trang web;
- kiểm tra hiển thị cuối cùng của các trang sau khi chỉnh sửa.
Kết quả
Nội dung trên các trang phải trông gọn gàng, nhất quán và không có dấu hiệu rõ ràng của việc cập nhật trang web kém chất lượng.
Ворклоги
Đã ghi nhận tiến độ về việc tự động khôi phục định dạng của nội dung cũ sau khi di chuyển từ draft-editor.
Một hàm giải quyết (resolver) đã được viết để lấy các biến thể nội dung cũ (contentText và content) và thông qua tác nhân AI để lắp ráp lại bài đăng sang định dạng Markdown trong khi vẫn giữ nguyên các từ ngữ, ý nghĩa và phong cách ban đầu.
import { Resource } from '@prisma/client'
import { PrismaContext } from 'server/context/interfaces'
import {
  LLMChatMessageRole,
  LlmModel,
  LlmProvider,
} from 'server/llm/client/interfaces'
import { llmChatCompletionResolver } from 'server/schema/types/LLM/resolvers/chatCompletion'

type ProcessConceptsArgs = {
  ctx: PrismaContext
  resource: Resource
}

export async function processOldContent({
  ctx,
  resource,
}: ProcessConceptsArgs): Promise<string | null | undefined> {
  const systemPrompt = `# Bạn là một biên tập viên viết lại (rewriter).

Bạn sẽ được cung cấp các biến thể văn bản khác nhau của cùng một bài đăng. Đây có thể là văn bản thuần túy hoặc văn bản kỹ thuật có chứa các thẻ kỹ thuật khác nhau, v.v. Nhiệm vụ của bạn là lắp ráp lại hoàn toàn bài viết, giữ nguyên các từ ngữ, ý nghĩa và phong cách, nhưng định dạng mọi thứ theo chuẩn Markdown.

Các danh sách mã nguồn (code listing) cũng có thể được cung cấp, cần đưa chúng vào một khối mã có chỉ định ngôn ngữ. Ví dụ:

\`\`\`js
const foo = 0
\`\`\`

Danh sách tất cả các ngôn ngữ được hỗ trợ:
'': 'Plain Text',
text: 'Plain Text',
js: 'JavaScript',
ts: 'TypeScript',
tsx: 'TypeScript (React)',
jsx: 'JavaScript (React)',
css: 'CSS',
html: 'HTML',
json: 'JSON',
bash: 'Bash',
shell: 'Shell',
sql: 'SQL',
gql: 'GraphQL',
python: 'Python',
markdown: 'Markdown',
django: 'Jinja/Django',
env: 'Environment',
yaml: 'YAML',

Nếu không có ngôn ngữ nào phù hợp, thì không cần chỉ định rõ ngôn ngữ được sử dụng.


## !!! Rất quan trọng !!!

Điều quan trọng là phải giữ nguyên ý nghĩa, từ ngữ và phong cách. Nhiệm vụ của bạn là định dạng lại bài viết chứ không phải viết lại theo ý của mình. Không được tự ý suy diễn, tưởng tượng hay thay đổi bất cứ điều gì. Nếu ở đâu đó có sự mơ hồ, thì sự mơ hồ đó phải được giữ nguyên — nhiệm vụ của bạn chỉ là định dạng lại bài viết.

Chỉ trả về bài viết đã được định dạng ở định dạng Markdown, không kèm theo bất kỳ mã kỹ thuật phụ trợ, văn bản, bình luận nào của bạn, v.v. Chỉ có bản thân bài viết.


## Định dạng của ấn phẩm cuối cùng

Markdown hợp lệ có hỗ trợ html (nhưng ưu tiên định dạng Markdown hơn)

Cần lưu ý rằng có nhiều nơi bị thiếu khoảng trắng trong văn bản. Việc nhận diện điều này và chèn khoảng trắng chính xác là rất quan trọng.

Hình ảnh được chèn dưới dạng hình ảnh có bản xem trước (preview). Liên kết dưới dạng liên kết.

Nếu gặp các liên kết trỏ đến tên miền community.modx-cms.ru, hãy chèn dưới dạng văn bản thông thường thay vì liên kết.
Đối với các tên miền khác, hãy chèn liên kết nguyên trạng.

Nếu có hình ảnh từ các dịch vụ lưu trữ file bên ngoài như joxi, v.v., không cần chèn chúng vì chúng không còn phù hợp. Nhớ chèn các hình ảnh cục bộ (local) ở những nơi chúng được chỉ định.
`

  const {
    content,
    contentText,

    /**
     * không lấy contentV2 vì nó được hình thành từ content và contentText
     */
    // contentV2
  } = resource

  const peaces = [contentText, content]
    .map((n) =>
      n === null ? null : typeof n === 'string' ? n.trim() : JSON.stringify(n),
    )
    .filter((n) => !!n)

  if (!peaces.length) {
    return ''
  }

  const userPrompt = `## Dưới đây là dữ liệu nguồn của bài viết. Hãy viết lại thành bài viết hoàn chỉnh ở định dạng Markdown, giữ nguyên từ ngữ, ý nghĩa và phong cách, và chỉ trả về nó cho tôi, không kèm theo bất kỳ văn bản kỹ thuật bổ sung hay bình luận nào của bạn

---

${peaces.join(`

---

`)}

`

  const chatResponse = await llmChatCompletionResolver(
    null,
    {
      input: {
        provider: LlmProvider.OpenRouter,
        messages: [
          {
            role: LLMChatMessageRole.system,
            content: systemPrompt,
          },
          {
            role: LLMChatMessageRole.user,
            content: userPrompt,
          },
        ],
        // eslint-disable-next-line @typescript-eslint/no-explicit-any
        model: LlmModel.GEMINI_3_5_FLASH_LITE as any,
      },
    },
    ctx,
  )

  const responseContent = chatResponse.choices?.[0]?.message?.content

  return responseContent
}
Thống kê thực hiện:
- 100 bài đăng — khoảng 5 phút, chi phí ~$0.30.
- 1296 tài nguyên — khoảng 43 phút, chi phí $2.53.
Nhìn chung, quá trình xử lý hoạt động tốt: văn bản trở nên dễ đọc hơn rõ rệt. Trước đó, sau khi di chuyển từ draft-editor, phần lớn các bài đăng thực tế đã biến thành một khối văn bản liền mạch không có định dạng ban đầu.
Đồng thời, quá trình xử lý tự động không mang lại kết quả hoàn toàn sạch sẽ và vẫn để lại một số dị vật (artifact) riêng lẻ. Ví dụ, có kết quả như sau:
В create- процессоре она есть, а в update- процессоре ее нет. Уточню, что это ключ массива данных, передаваемых в массив
s
c
r
i
p
t
P
r
o
p
e
r
t
i
e
s
,
доступныйвнавешиваемыхплагинах
.
Приэтомониещеисоветуютэтотключнеиспользовать
,
ииспользуйтетипаключ
scriptProperties,доступныйвнавешиваемыхплагинах.Приэтомониещеисоветуютэтотключнеиспользовать,ииспользуйтетипаключthis->objectType.
Mã HTML gốc của câu này:
<p>В create- процессоре она есть, а в update- процессоре ее нет. Уточню, что это ключ массива данных, передаваемых в массив <span class="katex"><span class="katex-mathml"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>s</mi><mi>c</mi><mi>r</mi><mi>i</mi><p>t</p><mi>P</mi><mi>r</mi><mi>o</mi><mi>p</mi><mi>e</mi><mi>r</mi><mi>t</mi><mi>i</mi><mi>e</mi><mi>s</mi><mo separator="true">,</mo><mtext>доступныйвнавешиваемыхплагинах</mtext><mi mathvariant="normal">.</mi><mtext>Приэтомониещеисоветуютэтотключнеиспользовать</mtext><mo separator="true">,</mo><mtext>ииспользуйтетипаключ</mtext></mrow><annotation encoding="application/x-tex">scriptProperties, доступный в навешиваемых плагинах. При этом они еще и советуют этот ключ не использовать, и используйте типа ключ </annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.8778em;vertical-align:-0.1944em"></span><span class="mord mathnormal" style="margin-right:0.0278em">scr</span><span class="mord mathnormal">i</span><span class="mord mathnormal" style="margin-right:0.1389em">ptP</span><span class="mord mathnormal" style="margin-right:0.0278em">r</span><span class="mord mathnormal">o</span><span class="mord mathnormal">p</span><span class="mord mathnormal" style="margin-right:0.0278em">er</span><span class="mord mathnormal">t</span><span class="mord mathnormal">i</span><span class="mord mathnormal">es</span><span class="mpunct">,</span><span class="mspace" style="margin-right:0.1667em"></span><span class="mord cyrillic_fallback">доступныйвнавешиваемыхплагинах</span><span class="mord">.</span><span class="mord cyrillic_fallback">Приэтомониещеисоветуютэтотключнеиспользовать</span><span class="mpunct">,</span><span class="mspace" style="margin-right:0.1667em"></span><span class="mord cyrillic_fallback">ииспользуйтетипаключ</span></span></span></span>this->objectType.</p>
Ở đây, vấn đề đã có sẵn trong mã HTML cũ: văn bản thông thường bị bọc trong KaTeX/MathML, khiến mô hình cố gắng diễn giải cấu trúc bị bóp méo nặng nề và đôi chỗ làm trùng lặp hoặc chia cắt văn bản.
Kết luận: xử lý tự động cải thiện đáng kể trạng thái cơ bản của nội dung và phù hợp làm bước lọc đầu tiên hàng loạt, nhưng việc rà soát cuối cùng và chỉnh sửa thủ công nhỏ là vẫn cần thiết.
Khối lượng — khoảng 1.500 chủ đề trong vòng 13 năm. Xét đến việc phần lớn nội dung sau khi xử lý đã khá dễ đọc bằng mắt thường và chỉ cần sự can thiệp thủ công ở một số ít dị vật và bố cục phức tạp ở vài chỗ, khối lượng công việc thủ công cuối cùng có vẻ hoàn toàn chấp nhận được.
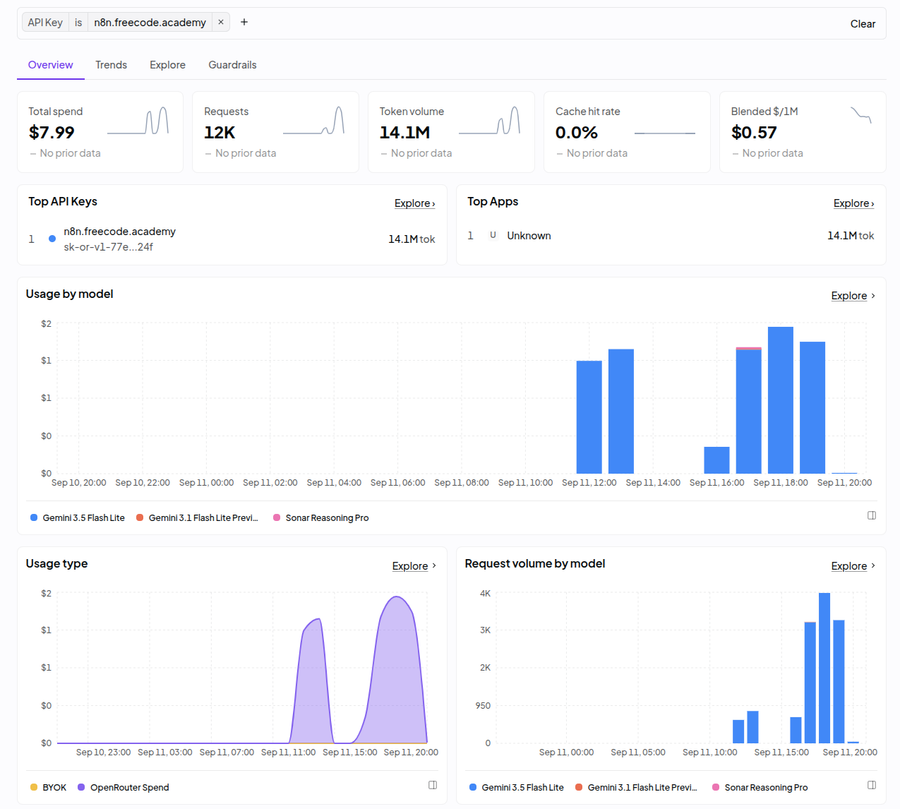
Đợt quét AI toàn diện trên kho tài nguyên và kinh tế học xử lý
Sau đợt quét đầu tiên qua các chủ đề, việc xử lý đã được mở rộng ra toàn bộ kho tài nguyên: chủ đề, bình luận, blog và các thực thể khác kế thừa từ mô hình chung Resource (về mặt lịch sử là từ MODX site_content).
Theo OpenRouter, tổng lượng yêu cầu cuối cùng là khoảng 12.000 yêu cầu AI, 14,1 triệu token và chi phí khoảng $7.99. Hầu hết việc xử lý hàng loạt được thực hiện trên Gemini 3.5 Flash Lite.
Con số này thực tế khớp với quy mô của kho lưu trữ hiện tại: chỉ riêng Topic + Comment đã mang lại 11.890 thực thể (1.349 chủ đề và 10.541 bình luận), và tính cả blog cùng các loại khác, tổng dung lượng tự nhiên đạt khoảng 12.000 tài nguyên.
Kết luận thực tế hóa ra còn quan trọng hơn cả bản thân việc chuyển đổi Markdown: một đợt quét AI được quản lý đầy đủ trên kho lưu trữ công khai nhiều năm chỉ tốn vài đô-la đơn lẻ. Ban đầu kỳ vọng khoảng 8.
Điều này làm thay đổi kinh tế học nội dung. Giờ đây, chúng ta không bị giới hạn ở việc di chuyển một lần, mà có thể thực hiện các đợt quét chuyên specialized lặp lại trên toàn bộ kho: chuẩn hóa, phân loại, trích xuất thực thể và nhận định, xây dựng mối quan hệ, tìm kiếm sự thay đổi về quan điểm, tổng kết theo chủ đề, provenance và chuẩn bị các ấn phẩm mới. Chi phí để máy đọc toàn bộ kho lưu trữ trở nên tương đương với một thao tác kỹ thuật thông thường chứ không phải công việc biên tập.
Ở cấp độ mô hình phân phối, điều này mang lại một kết luận nữa: con người có thể trao lõi tư duy cho AI, AI sẽ tự tra cứu và thu thập ngữ cảnh, sau đó xuất bản một tập hợp tài liệu được quản lý trên một hoặc nhiều trang web. Sau đó, các tài liệu này trở nên dễ tiếp cận với các tác nhân AI khác và có thể được đưa vào câu trả lời của chúng thông qua GEO/AI-search. Nói cách khác, việc tạo hàng loạt giá trị rẻ ở đây không được sử dụng để spam, mà như một hạ tầng xuất bản được quản lý nhằm phân tán các ý tưởng và chuyên môn có thể kiểm chứng.